
أظهرت
دراسة حديثة أن نظاماً للذكاء الاصطناعي طورته شركة مايكروسوفت حقق دقة
بلغت نحو 83 بالمئة في تشخيص حالات طبية معقدة، متجاوزاً نتائج أطباء
ممارسين عامين شاركوا في اختبار محاكاة، في نتائج قد تعزز دور الذكاء
الاصطناعي في دعم القرارات الطبية، بحسب ما أوردته شبكة فوكس نيوز Fox
News، وترجمته وكالة النبأ.
ووفقاً للدراسة المنشورة في 22 أكتوبر تشرين
الأول في مجلة ساينس، تمكن نظام الذكاء الاصطناعي، المعروف باسم MAI
Diagnostic Orchestrator أو MAI-DxO، من تحديد التشخيص الصحيح في 83 بالمئة
من الحالات، مقارنة بنسبة 36 بالمئة للأطباء الذين استعانوا بالمراجع
الطبية، و22 بالمئة للأطباء الذين لم يُسمح لهم باستخدامها.
لكن
الباحثين أشاروا إلى أن النتائج تحققت في بيئة اختبار محاكاة، وليس خلال
تقديم الرعاية لمرضى حقيقيين، كما أن المقارنة لم تشمل فرقاً من الأطباء
المتخصصين الذين يتعاملون عادة مع الحالات الطبية شديدة التعقيد.
نظام يعتمد على عدة وكلاء للذكاء الاصطناعي
ويعمل
نظام MAI-DxO من خلال تنسيق مجموعة من وكلاء الذكاء الاصطناعي، الذين
يتعاونون في تحليل الحالة الطبية وطرح أسئلة إضافية وتحديد الفحوصات
اللازمة، قبل مراجعة الاستنتاجات والتوصل إلى تشخيص مرجح.
وقالت
مايكروسوفت إن النظام اختُبر على 304 حالات طبية معقدة منشورة في مجلة نيو
إنجلاند الطبية، وهي حالات تتضمن أمراضاً غير شائعة تتطلب تحليلاً دقيقاً
للأعراض والنتائج المخبرية والتاريخ الطبي.
ويختلف هذا النهج عن أنظمة
المحادثة التقليدية التي تقدم إجابات مباشرة استناداً إلى المعلومات
المتاحة، إذ يتيح للنظام إعادة تقييم الفرضيات الطبية مع ورود معلومات
جديدة، وطلب اختبارات إضافية عند الحاجة.
وفي اختبار منفصل شمل حالات
تاريخية من أقسام الطوارئ، سجل النظام دقة بلغت نحو 80 بالمئة، مقابل 47
بالمئة للأطباء المشاركين في المقارنة.
تحفظات بشأن نتائج الدراسة
ورغم النتائج، تثير منهجية الدراسة تساؤلات بشأن مدى إمكانية تعميمها على الممارسة الطبية اليومية.
فالأطباء
المشاركون كانوا من الممارسين العامين وأطباء الرعاية الأولية والطب
الباطني العام، وعالجوا الحالات بصورة فردية، بينما لم تتضمن المقارنة
فرقاً متعددة التخصصات أو استشاريين متخصصين في الأمراض المعقدة.
كما
تعامل الأطباء مع مجموعة أصغر بلغت 56 حالة، في حين اختُبر النظام على 304
حالات، وهو اختلاف ينبغي أخذه في الاعتبار عند مقارنة نسب الأداء.
واستند
الاختبار إلى سجلات طبية سابقة بدلاً من التعامل المباشر مع المرضى، وهو
ما يعني أن النظام لم يواجه جميع التحديات التي تظهر في الممارسة السريرية،
مثل نقص المعلومات وصعوبة وصف الأعراض واختلاف استجابة المرضى للأسئلة.
وتعتمد
القرارات الطبية كذلك على الفحص السريري ومتابعة تطور الحالة وتقييم
الظروف الفردية للمريض، وهي جوانب لا تقيسها اختبارات التشخيص النصية بصورة
كاملة.
ويعمل مؤلفو الدراسة لدى مايكروسوفت، الأمر الذي يعزز
أهمية إجراء تقييمات مستقلة للتحقق من النتائج قبل اعتماد النظام في
المؤسسات الصحية.
أداء نماذج الذكاء الاصطناعي
وأظهرت
الدراسة أيضاً أن نماذج الذكاء الاصطناعي الأساسية تمتلك قدرات تشخيصية
مرتفعة حتى دون استخدام نظام التنسيق الذي طورته مايكروسوفت.
فقد
حقق نموذج GPT-5 التابع لشركة أوبن إيه آي دقة تقارب 79 بالمئة عند استخدام
توجيه أساسي، وارتفعت النسبة إلى نحو 83 بالمئة عند دمجه مع نظام MAI-DxO.
وفي اختبار آخر باستخدام نموذج GPT-5.5، ارتفعت دقة التشخيص من نحو 72 بالمئة إلى ما يقارب 87 بالمئة عند استخدام نظام التنسيق.
وتشير
النتائج إلى أن آليات التنسيق بين وكلاء الذكاء الاصطناعي قد تحسن أداء
النماذج في بعض الحالات المعقدة، لكن حجم التحسن يختلف باختلاف النموذج
ونوع المهمة الطبية.
وتسعى مايكروسوفت إلى تطوير ما تصفه بالذكاء
الطبي الفائق، وهو مفهوم يهدف إلى إنشاء أنظمة قادرة على دعم التفكير
السريري وتحليل الحالات الطبية المعقدة.
كما تتعاون الشركة مع مؤسسة مايو كلينك في تطوير تطبيقات للذكاء الاصطناعي يمكن أن تساعد الأطباء على توقع تطور الحالات الصحية.
خفض محتمل لتكاليف الفحوصات
وتناولت الدراسة أيضاً قدرة النظام على الموازنة بين دقة التشخيص وتكلفة الإجراءات الطبية.
وفي أحد سيناريوهات الاختبار التي ركزت على خفض النفقات، حقق MAI-DxO دقة بلغت نحو 81 بالمئة، بمتوسط تكلفة تشخيصية تقديرية قدره 2241 دولاراً للحالة الواحدة.
وفي المقابل، بلغ متوسط التكلفة التقديرية للفحوصات التي أجراها الأطباء باستخدام المراجع الطبية نحو 4725 دولاراً للحالة.
لكن الباحثين أشاروا إلى أن إعدادات أخرى تستهدف تحقيق أعلى دقة ممكنة أدت إلى زيادة تكاليف الفحوصات، ما يعني أن حجم التوفير يرتبط بطريقة ضبط النظام والأهداف المحددة له.
ولا تمثل هذه الأرقام فواتير فعلية للمرضى أو تكاليف تشغيل النظام، بل تقديرات مستمدة من الإجراءات التشخيصية التي جرى تقييمها خلال المحاكاة.
اختبارات في مستشفيات حقيقية
وتعتزم مايكروسوفت الانتقال إلى مرحلة اختبار النظام في بيئة سريرية فعلية، من خلال تعاون مع مركز بيث إسرائيل ديكونيس الطبي في بوسطن.
وبحسب الخطة المعلنة، سيواصل المرضى المشاركون تلقي الرعاية الطبية المعتادة، بالتزامن مع تقييم توصيات نظام الذكاء الاصطناعي ومقارنتها بالتقييمات الطبية المستقلة.
وسيظل الأطباء مسؤولين عن القرارات العلاجية، فيما تهدف التجربة إلى تحديد مدى موثوقية النظام عند التعامل مع مرضى حقيقيين وظروف سريرية أكثر تعقيداً من بيئات الاختبار.
وتعمل شركات تقنية أخرى على تطوير أنظمة مماثلة، من بينها جوجل، التي نشرت دراسة في مجلة ذا لانسيت بشأن نظامها الطبي الحواري AMIE.
وشملت الدراسة 98 مريضاً تفاعلوا مع النظام قبل مواعيدهم مع أطباء الرعاية الأولية العاجلة، فيما راقب الأطباء المحادثات في الوقت الفعلي.
وأفاد الأطباء بأن المعلومات التي وفرها النظام ساعدتهم في كثير من الحالات على الاستعداد للمواعيد الطبية، ولم تُسجل حالات استدعت تدخلاً لأسباب تتعلق بالسلامة وفق المعايير المحددة مسبقاً في الدراسة.
الذكاء الاصطناعي مساعد للأطباء وليس بديلاً عنهم
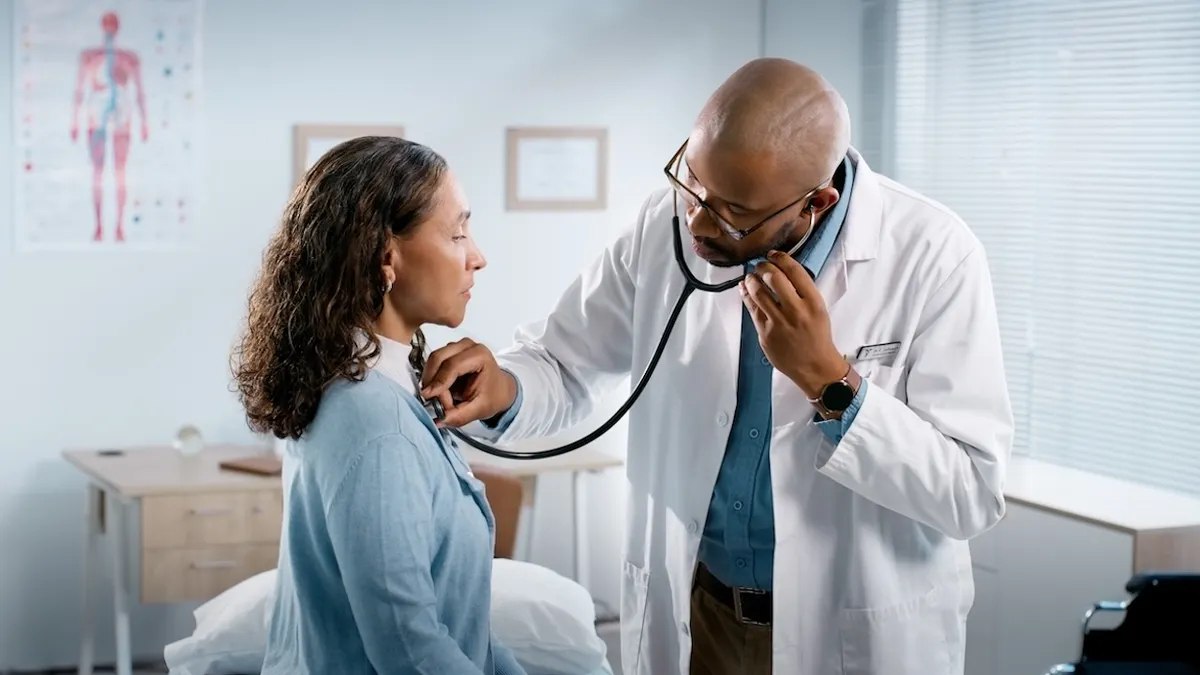
وتسلط نتائج الأبحاث الضوء على إمكانات الذكاء الاصطناعي في دعم تشخيص الأمراض النادرة والمعقدة، ومساعدة الأطباء على تقييم الاحتمالات المرضية وتحديد الفحوصات الأكثر أهمية.
لكن الانتقال من الأداء في الاختبارات إلى الاستخدام السريري يتطلب إثبات قدرة هذه الأنظمة على تقديم نتائج موثوقة مع مرضى حقيقيين، فضلاً عن تقييم مخاطر الأخطاء والتحيزات المحتملة.
كما تظل حماية البيانات الطبية من القضايا الأساسية المرتبطة باستخدام هذه التقنيات، خصوصاً مع تزايد اعتماد الأنظمة الذكية على تحليل السجلات الصحية والمعلومات الشخصية.
ولا تزال تقنية MAI-DxO في مرحلة البحث والتقييم، ولم تثبت حتى الآن قدرتها على استبدال التقييم الطبي المتخصص.
ويرى مراقبون أن الاستخدام الأكثر ترجيحاً لهذه الأنظمة في المرحلة المقبلة يتمثل في تقديم دعم إضافي للأطباء، ولا سيما عند التعامل مع الحالات التي يصعب تشخيصها، مع إبقاء القرارات الطبية النهائية تحت إشراف المختصين.
مرصد الذكاء الاصطناعي
ذكاء اصطناعي من مايكروسوفت يتفوق على أطباء في اختبار لتشخيص الحالات الطبية المعقدة
أخبار ذات صلة
التعليقات (0)
كن أول من يكتب تعليقاً.
أضف تعليقاً